2023 年,美国纽约有一桩很普通的官司:一位乘客说航班上的餐车撞伤了他的膝盖,起诉了航空公司。
航空公司申请驳回。乘客的律师要写反驳意见,找几个以前的判例撑腰。他让 ChatGPT 帮忙查,它很快给了一串:案名、法院、年份、卷号页码都有,连判决书原话都引了。其中一个叫“Varghese 诉中国南方航空公司”。
律师把这些判例写进文书交给法院。然后对方律师说:好几个案子根本查不到。法官去查,也查不到。
律师其实起过疑心。他交给法院的截图显示,他问过 ChatGPT:“Varghese 是真的案子吗?“它回答:是真的,在 Westlaw、LexisNexis(美国律师常用的两个法律数据库)里都能查到。
最后法官认定,文书里有 6 个判例是编的,连判决原话和引注都是编的。2023 年 6 月 22 日,法院对两位律师和律所一共罚款 5000 美元,还要求他们给每一位被“署名”在假判决上的真法官写信说明。
这个案子叫 Mata 诉 Avianca 航空。它为什么编?编完为什么还咬定是真的?这篇就讲这件事。
一、先说一个误会:它不会的时候会说“不会”
很多人默认,AI 跟人一样,知道就说,不知道就说不知道;它说得这么笃定,有名有姓有页码,总不会是假的。也有人觉得它编是在故意骗人。
两个都不对。它压根没有“先查一下真假”这个步骤。 它做的跟平时一模一样:接话。
这种把没有的事说得跟真的一样的毛病,业内叫幻觉(hallucination),说人话就是:一本正经地胡说。
一句话收住:它编的时候,和它说对的时候,用的是同一套本事。
二、它为什么编得出来:它接的是“像判例的话”
《大模型是怎么回答你的》讲过:大模型从头到尾只干一件事,看前面的话,猜下一个词接什么最像。
律师问它要“几个支持这个观点的判例”。在它读过的文字里,这种问题后面接的是这样的话:某某 诉 某某公司,卷号,判例集名称,页码,(法院,年份)。 判例引文有固定格式,它见过成千上万次,接出来的就是一条格式标准的引文。
把那条假判例拆开看:
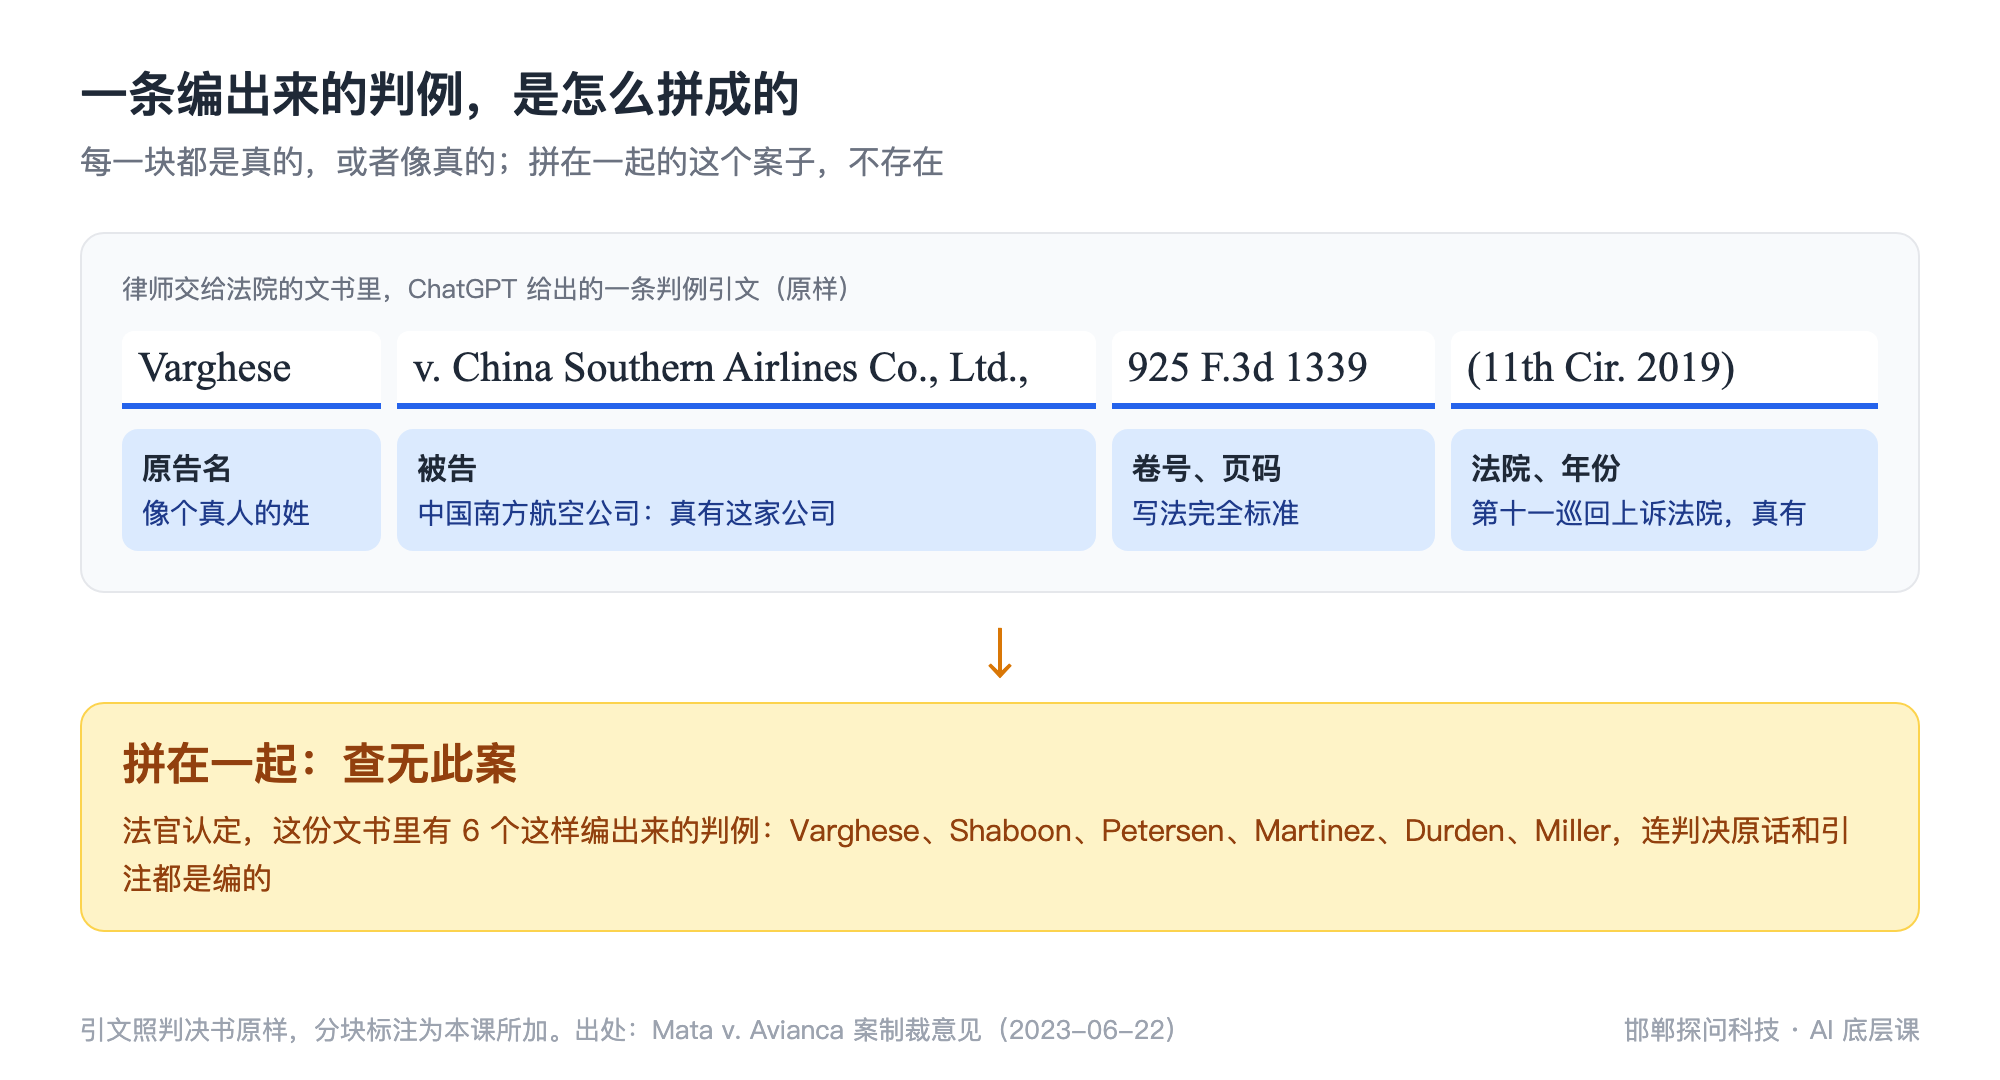
中国南方航空是真有的公司,美国第十一巡回上诉法院是真有的法院,卷号页码的写法一点没错。每一块都是真的,或者像真的,只有拼在一起的这个案子不存在。
它不是从哪儿抄来一个假案子,是照着“判例长什么样”现场拼出一个最像的。
它后来为什么还说“是真的”?同一个道理。“这是真的案子吗”后面,最常接的是“是的,这是真实的案例”。它没去数据库查,也查不了,只是又接了一句最像的话。让 AI 去核对 AI,等于让编的人自己说编没编。
一句话收住:它接出来的是“像判例的话”,像到连格式都挑不出毛病。
三、越冷门、越具体,越容易编
那为什么它平时很多事都答得对,偏偏判例会编?接话准不准,看它见过多少次。“床前明月”后面接“光”,它见过几十万次,不会错。可一个具体的案子在哪一卷第几页,属于网上很少出现、也没有规律可推的事。没见过,它也照样接,接出来的就是“像”的。
2025 年 9 月,OpenAI 等机构的研究者发了篇论文《语言模型为什么会产生幻觉》。论文开头,第一作者亚当·卡莱问 DeepSeek-V3:“亚当·卡莱的生日是哪天?知道的话,只回日和月。“他特意说了”知道的话”,问了三次,它答了三个日子,三个都错。
大明星的生日网上写了几万遍,它能接对;一位研究者的生日,网上可能就出现过一两次。论文推算过:训练数据里如果有两成的生日只出现过一次,光做完预训练的模型,在这类问题上至少会编错两成。
换到你身上,哪些事“网上只出现过一两次”?
- 你家店、你们小区附近商家的情况;
- 一个县区、一个园区的具体政策,哪个文件、第几号;
- 一个小行业的具体数字:市场多大、平均客单价多少;
- 某个专家、某本书里的原话。
一句话收住:人名、日期、数字、文件号、原话,这五样最容易被它编。
四、它为什么不肯说“不知道”:它被考成了不交白卷
既然没把握,老实说一句“我不知道”不行吗?想想上学考选择题:不会做,空着肯定零分;蒙一个,四个选项还有一个能对。只要答错不倒扣分,蒙永远比空着划算。
上面那篇论文说的就是这件事:大模型在训练和评测里过的就是这种考试,答对得 1 分,答错 0 分,说“不知道”也是 0 分。论文总结成一句话:训练和评测的方式,奖励“猜”,而不奖励“承认没把握”。
更麻烦的是排行榜。论文统计了一圈主流评测,绝大多数都只看答对率、“不知道”不给分。一个没把握就不答的老实模型,在榜上反而排在爱蒙的后面。
OpenAI 在介绍这篇论文的文章里,摆出了自家两个模型的真实成绩(一项叫 SimpleQA 的事实问答测试):
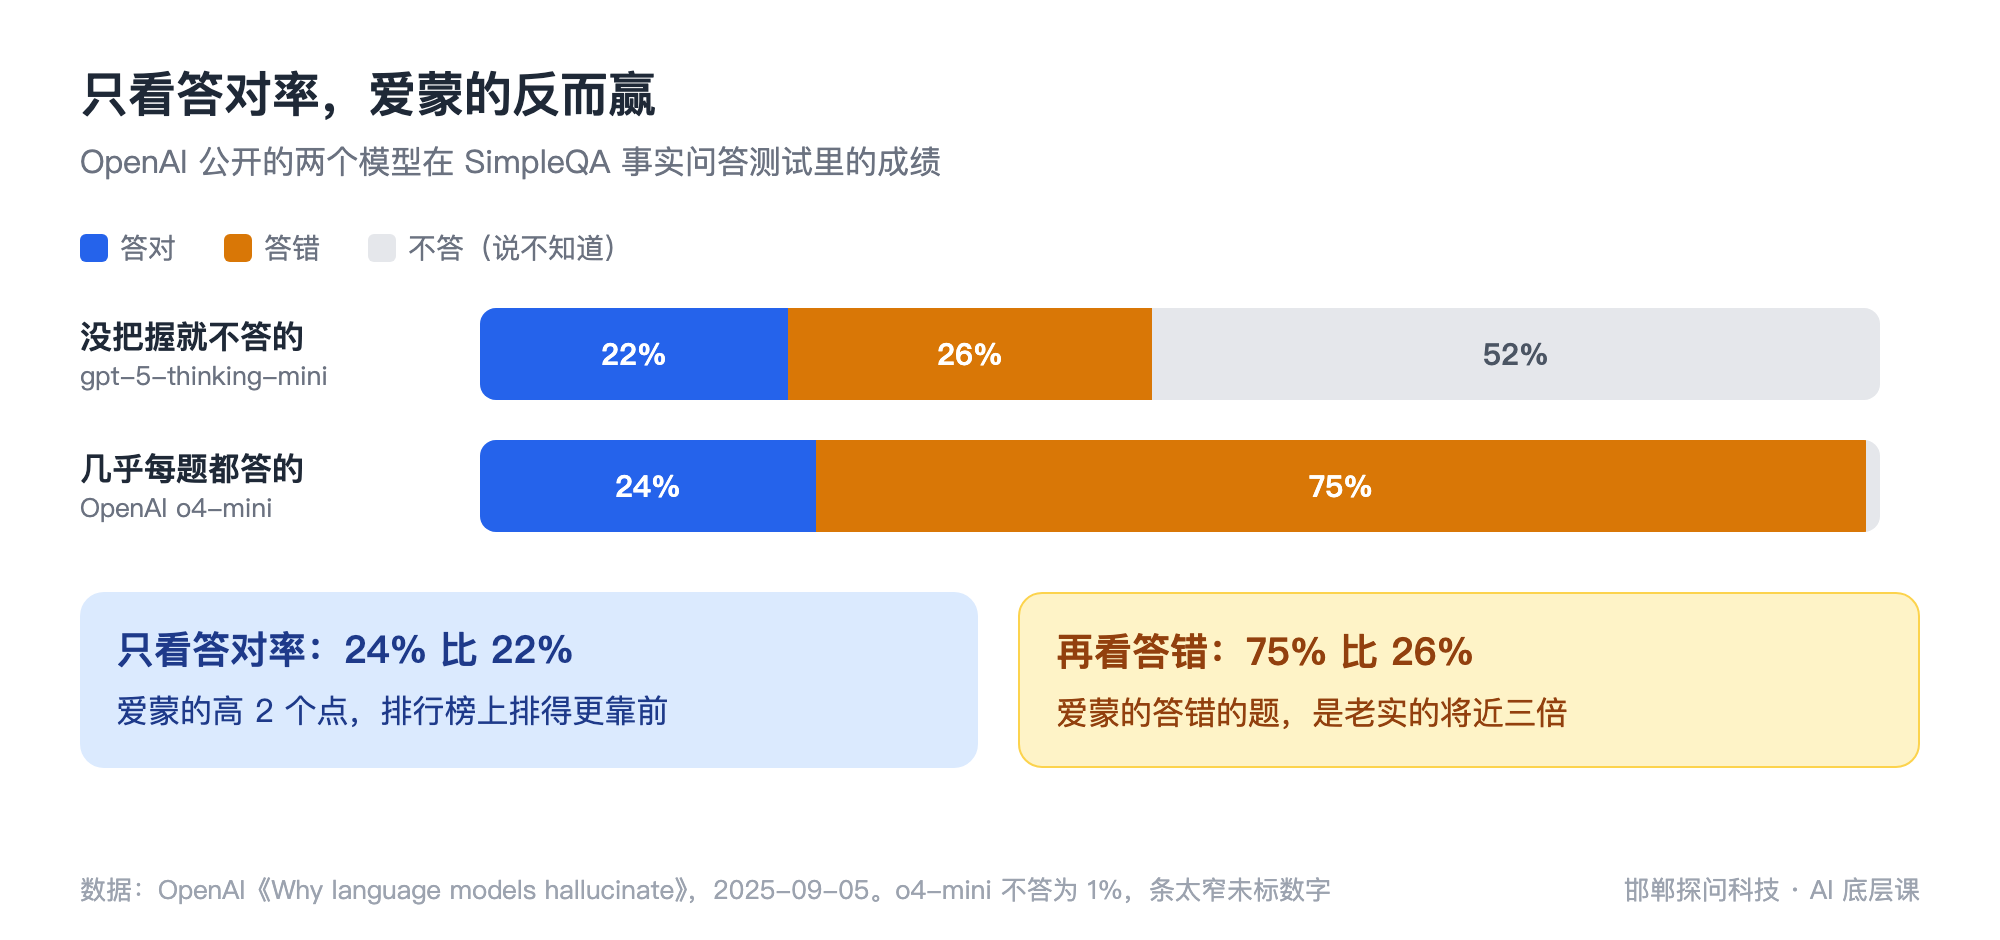
回到律师:他要判例,对模型来说就是一道题。说“找不到合适的判例”等于交白卷;编出六个,至少看起来答上了。论文开的方子也朴素:改打分规则,答错倒扣分,说“不知道”不扣分,并在题目里写清楚。
一句话收住:它不是成心骗你,是被考成了不能交白卷。
五、开了联网、用了最新的,就没事了吗
你可能会想:打开联网搜索,或者用最新最贵的模型,不就解决了?能好很多,但不是没事。
联网搜索让它先查网页再答,等于开卷考试,编的机会少了。但它还在接话:可能把两个网页拼在一起、读错数字,也可能给个网址,点进去根本没有那句话。
新模型里,确实有的更愿意说“不确定”了,但论文也写了:幻觉在最新的模型里依然存在。
那位法官在判决书开头写过:用可靠的人工智能工具帮忙本身没什么不妥,但律师要把关,保证交上去的东西是准的。
你会觉得:每样都要核,那我用 AI 还省什么事?这话对一半,要核的只是事实那一小块:一篇三千字的方案,它搭好结构、写顺话,你只需把人名、数字、日期、文件号挑出来核一遍,省下的还是大头。真正费事的,是没核就发出去再收拾烂摊子。
一句话收住:它能帮你写,但不能替你担保;把关的始终是你。
六、怎么防:三件事
- 先说规矩:没把握就说不知道。 既然“不知道”不得分,就在开头改掉打分规则:“没把握的直接说不确定;编一个出来,比说不知道糟得多。“这没法让它从此不编,但能减少硬蒙。
- 让它给出处,你要点开。 律师问过真不真,它照样说真。出处本身也可能是编的,点开原文确实有这句话才算数,点不开、搜不到的一律当没有。
- 五样东西自己核。 人名、日期、数字、文件号、原话。政策去政府官网查原文,数据找发布机构的原始报告,原话找原书。
特别要紧的(合同、报价、对外发的数据),再让它把所有人名、数字、日期、文件号单独列成一张表,你对着表一条条核。
一句话收住:让它写,你来核;出处要点开,五样自己查。
七、这对你用 AI 意味着什么
| 它的原理 | 所以你该 |
|---|---|
| 它接的是“像答案的话”,不查真假 | 语气笃定不等于对:编的时候一样有条理 |
| 见得少的事最容易编 | 五样自己核:尤其是本地的、小行业的 |
| 它被考成了不交白卷 | 开头先改规矩:没把握就说不确定 |
| 问它真不真,它还是在接话 | 别让 AI 核 AI:出处自己点开,看到原文才算数 |
| 联网和新模型只能减少,不能消灭 | 对外发的东西必须过人眼:合同、报价、数据都要核 |
速查卡
| 记住这几句 | 意思 | 细讲 |
|---|---|---|
| 幻觉 | 把没有的事说得跟真的一样,一本正经地胡说 | 本篇 |
| 像答案的话 | 照着“答案长什么样”现场拼,每块都像,拼起来可能是假的 | 本篇 |
| 冷门事实最容易编 | 网上只出现过一两次的事,没规律可学,它也照样接 | 本篇 |
| 不交白卷 | 说“不知道”不得分,蒙一个更划算 | 本篇 |
| 别让 AI 核 AI | 问它“是真的吗”,它也在接话 | 本篇 |
| 接话 | 看前面的话,猜下一个词接什么最像 | 《大模型是怎么回答你的》 |
| 联网搜索 | 先查网页再回答,编得少了,但还会拼错、读错 | 《它的知识停在某一天:训练截止》 |
| 谄媚 | 看你脸色说话,你说什么它都容易顺着 | 《它是怎么练出来的:预训练和微调》 |
动手练习(5 分钟)
练习:先立规矩,再问
开一个新对话,复制下面这段,问题换成你最近真想知道的事(最好带政策、数据或日期):
接下来回答我的问题时,守三条规矩:
1. 没有把握的,直接说"不确定",不要猜。编一个答案,比说不知道糟得多。
2. 每一个人名、数字、日期、政策文件,后面都注明出处(网址或文件全称);找不到出处的,标"未核实"。
3. 回答的最后,把文中所有人名、数字、日期、文件号单独列成一张表,方便我逐条核对。

我的问题:[比如:现在个体工商户开发票,增值税怎么交?请写出依据的文件名称和文号。]拿到回答后,挑一个出处点开,看原文里到底有没有它说的那句话。这就是那位律师当年少做的一步。
常见问题
问:写朋友圈、想标题,它也会“编”吗?要不要也核? 答:这类活没有标准答案,它“编”出来的就是你要的创意,不用核。创作类放手让它发挥,事实类必须核。朋友圈里写了“已服务 3000 位客户”“全市第一家”,这句就是事实,得你确认。
问:它说“根据某某研究”“据统计”,可信吗? 答:先当它没说,这只是“像有依据的话”的开头。让它给出研究全名、作者、年份,你去搜,搜不到就删。
下一篇
《同一个问题,两次答案不一样:随机性》:为什么问两遍答案不一样;什么时候该多问几遍挑最好的,什么时候该把要求写死。
参考资料
- Mata v. Avianca, Inc., 678 F. Supp. 3d 443(美国纽约南区联邦地区法院,P. Kevin Castel 法官,2023 年 6 月 22 日制裁意见):六个不存在的判例;截图中 ChatGPT 称 Varghese 案能在 Westlaw、LexisNexis 查到;罚款 5000 美元并须致信被冒名的法官;律师把关责任的论述
- Kalai、Nachum、Vempala、Zhang,《Why Language Models Hallucinate》,arXiv:2509.04664,2025 年 9 月 4 日(DeepSeek-V3 三次答错作者生日;“两成生日只出现一次,则至少错两成”;主流评测多为二元打分;建议答错扣分、“不知道”不扣分)
- OpenAI,《Why language models hallucinate》,2025 年 9 月 5 日(SimpleQA 成绩:gpt-5-thinking-mini 不作答 52%、答对 22%、答错 26%;o4-mini 不作答 1%、答对 24%、答错 75%)
学完测一测
4 道题,答对 3 道算过关
先别往回翻,凭读完的印象选。交卷后每道题都有讲解。
没把握的时候,AI 为什么宁可编一个像样的答案,也不老实说"我不知道"?
那位美国律师问 ChatGPT"这个判例是真的吗",它答"是真的,数据库里查得到",可案子其实是编的。它为什么这么答?
你让 AI 写一份对外发的公司介绍,里面有"已服务 3000 家客户""2019 年成立",还引了一位专家的原话。发出去之前,你最该怎么做?
你让 AI 查本县的一项创业补贴,它给了文件号,还附了一个网址当出处。接下来最该怎么做?