你一定碰到过这种事。给 AI 发一句:
帮我写一条100字的朋友圈,宣传周末的会员活动。
它写回来,一数,130 多字。你说“严格 100 字”,它改完,又只剩 70 来字。来回几次,就是卡不准。
还有一件事:用 WorkBuddy 这类软件,或者开了 DeepSeek 的接口,账单上写的不是“用了多少字”,而是“用了多少 token”。
这两件事,根子是同一个:它读的不是字。
一、先说一个误会:它不是一个字一个字地看
我们看那句话,是一个字一个字看的:帮、我、写、一、条……一共 24 个字(“100”算 3 个,标点也算上)。
很多人以为 AI 也这么看。上一篇为了好讲,也先让你“粗略当成一个字”(见《大模型是怎么回答你的》)。现在把这句话纠正过来:它看到的是一块一块的。
拿 DeepSeek 公开的词表来切这句话,结果是这样的:
帮我|写|一条|100|字|的朋友|圈|,|宣传|周末|的|会员|活动|。
24 个字,切成了 14 块。“帮我”是一块,“100”是一块,最怪的是“的朋友”成了一块,“圈”反倒单独一块。
这一块一块的东西,业内叫 token,中文叫词元。说人话:它读文字的最小单位,不是字,是字块。 它接话也是一块一块吐出来的。
一句话收住:你看到的是 24 个字,它看到的是 14 块。
二、块是怎么切出来的:一本“练”出来的词库
为什么是“的朋友”一块,不是“朋友圈”一块?这是统计出来的。
用过拼音输入法就好理解。打“jintian”,输入法直接给你“今天”,因为这个词常用,词库里早就收了;打一个生僻的人名,就得一个字一个字挑。常用的成块,少见的拆散。
大模型的词库也是这个思路,只不过是机器自己统计的:
- 先从最碎的单位起步,比一个字还碎:电脑存一个汉字通常要 3 个字节,就从字节开始。
- 在海量文字里数一数,哪两块最常挨在一起,就粘成一块新的,记进词库。
- 一轮一轮重复,直到词库攒到定好的大小。
这个办法业内叫 BPE(字节对编码),说人话就是”谁常在一起,就把谁粘成一块“。DeepSeek、千问、GPT 用的都是这一类办法。粘到最后,DeepSeek-V3 的词库有十二万多块(技术报告写的是约 128K),这本词库业内叫词表。
所以“人工智能”这种天天见的词粘成一整块;“的朋友”在网上出现得太多(“我的朋友”“你的朋友”),也粘到了一起,跟我们理解的“词”不是一回事。
那一个汉字平均是几块?DeepSeek 官方文档给过一个大致的换算:1 个中文字符约 0.6 个词元,1 个英文字符约 0.3 个词元。上面那句 24 个字切成 14 块,正好差不多是 0.6。
一句话收住:词元是按“谁常在一起”粘出来的,常见的粘成大块,少见的拆成碎块。
三、换一个模型,同一句话块数就不一样
既然词库是各家自己练的,那每家切出来的就不一样。
同一句话,拿三家公开的词表实测:
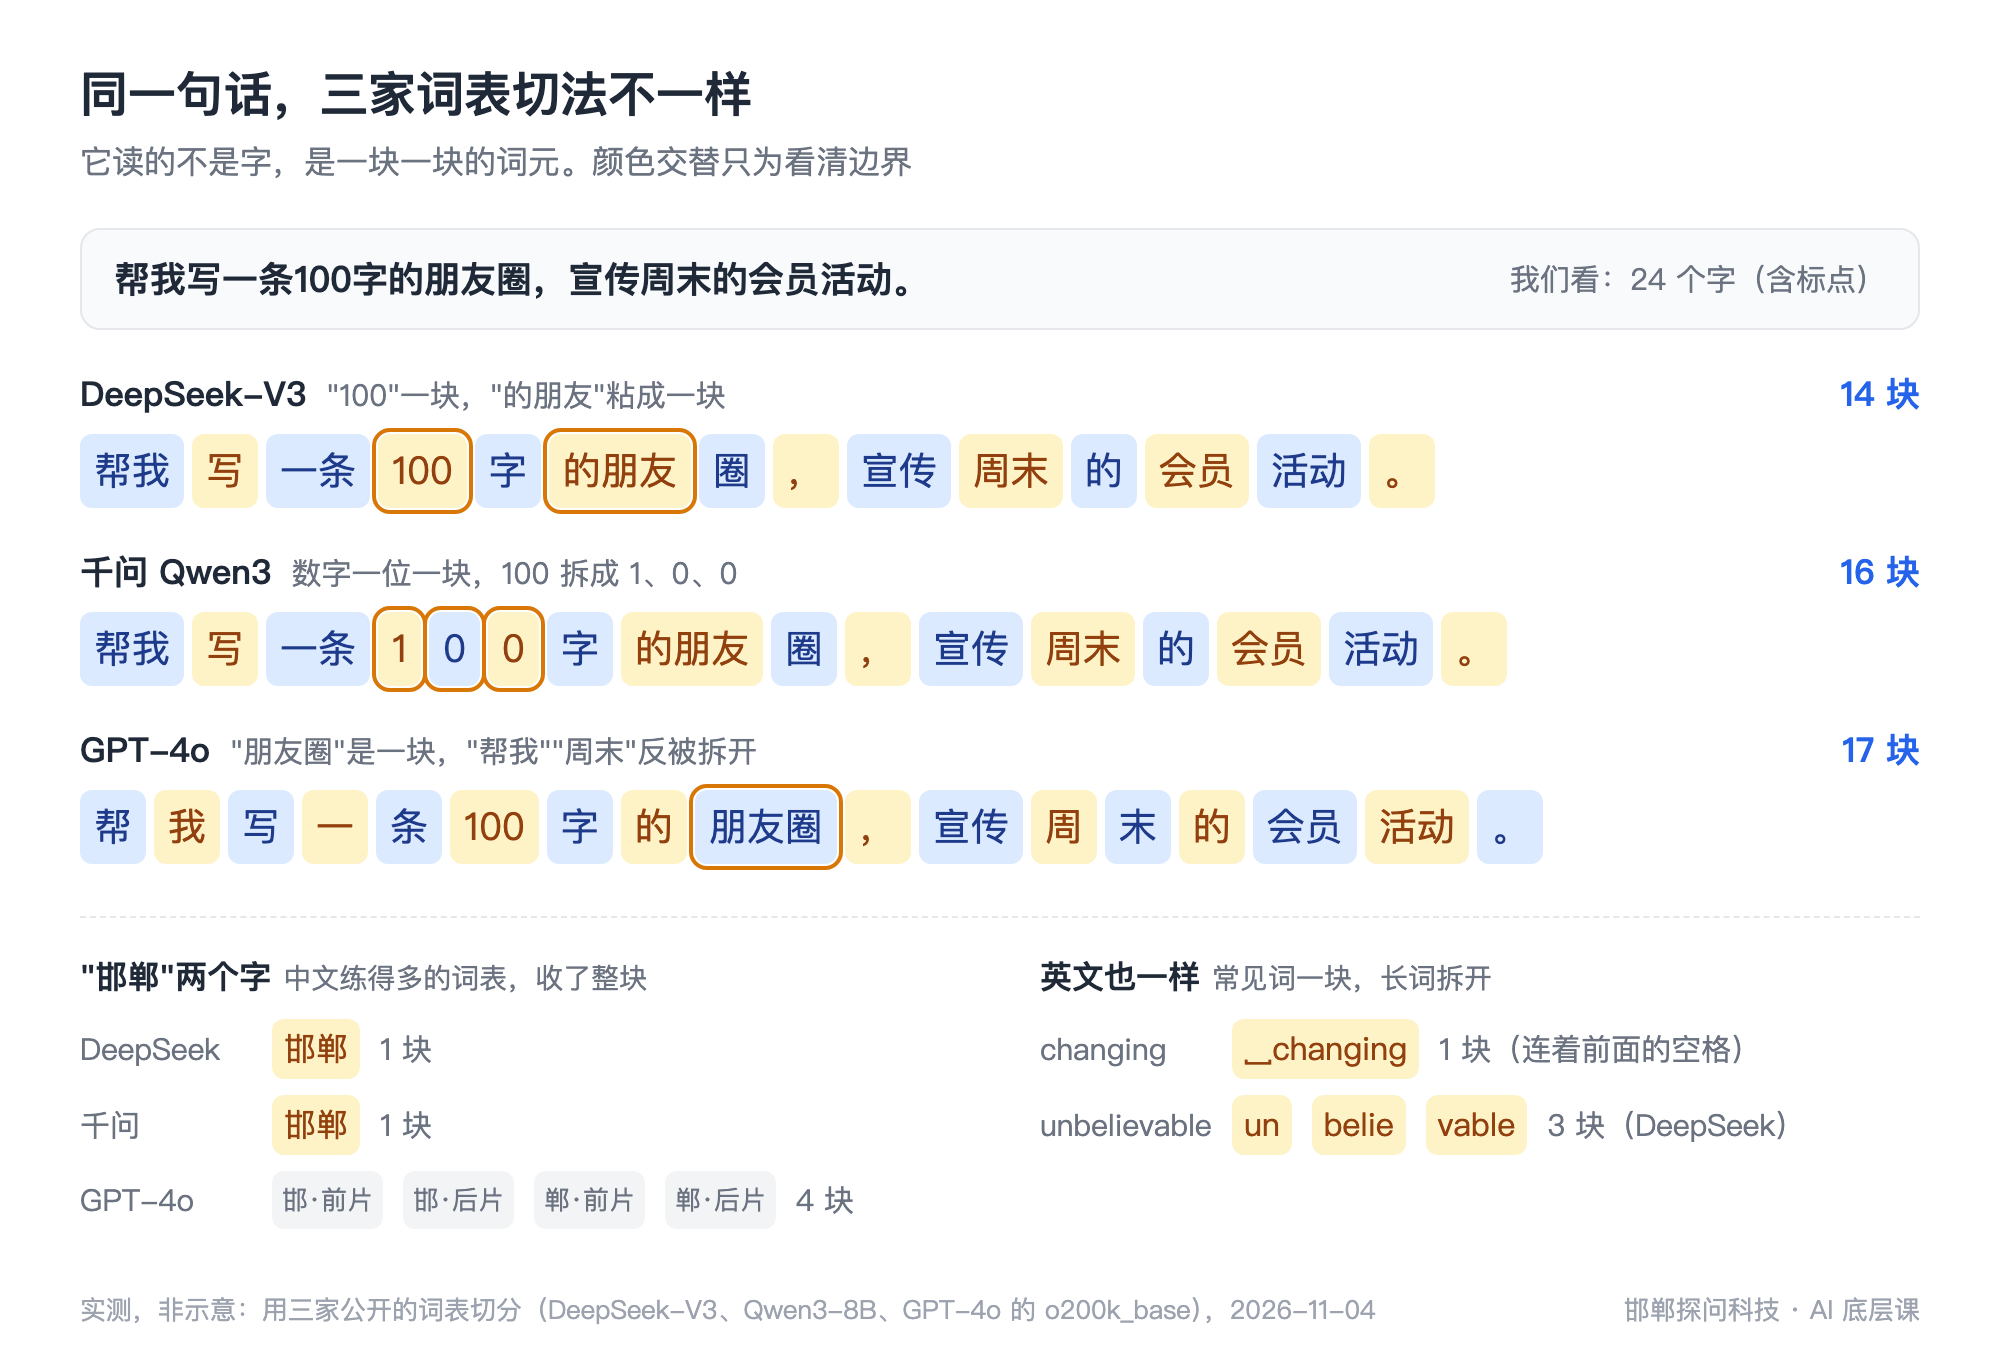
DeepSeek 切 14 块,千问切 16 块(它把 100 拆成了 1、0、0),GPT-4o 切 17 块。中文资料练得多的模型,中文词收得多,同样的中文用的块就少。
落到你身上有两个后果:
- “能装多少”不能直接比:两个模型都说一次能读 100 万词元,换成汉字不一定一样多。
- “多少钱”不能只看单价比:单价一样,块数不一样,花的钱也不一样。实际用了多少,以软件显示的用量为准。
一句话收住:词元不是统一的尺子,每家的刻度都不一样。
四、为什么字数总写不准
现在回到开头那条朋友圈。
它卡不准 100 字,有两个原因。
第一,它眼里没有“一个字”这个单位。 它手里的是一块一块的词元,有的一块一个字,有的一块两三个字,有的一个字还要拆成两片。让它数字数,就像让你拿一把刻度忽大忽小的尺子量布,每一格多长都不一样,量出来自然不准。
第二,它是一块一块往下接的,不会停下来数。 它不会写到一半回头数“我已经写了 63 个字,还剩 37 个”,只是在接“一条 100 字的朋友圈大概长什么样”。
你可能会说:那我把话说重一点,“严格 100 字,多一个字都不行”?
会更接近,但不保证。原因不在它态度:你要它按字算,它是按块看的。
真要卡字数,有三个办法:
- 给范围,别给死数:“80 到 120 字”比“100 字”容易做到,也更符合发朋友圈的实际需要。
- 让它用工具数:在 WorkBuddy、Codex 这类能动手的智能体里,让它写完跑一个小程序数字数,不对再改。程序是一个字一个字数的(智能体怎么用工具,见《智能体是怎么替你干活的》)。
- 自己数:复制到 WPS 或 Word 里看字数统计,几秒钟的事。
一句话收住:它不是不听话,是它眼里压根没有“一个字”这个单位。
五、按词元收钱:你发过去的、它写回来的,都算
再说钱。
大模型像一位只能打电话的老师傅,这通电话按词元计费,跟话费按分钟算一个道理。DeepSeek 官方的说法是,按输入和输出的总词元数计费。
- 输入:你这一次发过去的全部东西。不光是你刚打的那句话,还包括你附上的文件、前面的聊天记录、开了联网搜索时搜回来的网页。
- 输出:它写回来的东西。
两样单价不一样,写回来的更贵。拿 DeepSeek 举例(截至 2026 年 11 月 4 日官方价格页,deepseek-flash 模型,工作日高峰时段):
| 每 100 万词元 | |
|---|---|
| 输入 | 2 元 |
| 输出 | 8 元 |
输出是输入的 4 倍。价格会变,但“按输入、输出分开算,输出更贵”这个规矩,各家基本都是这样。
一句话收住:你念过去的、它说回来的,都按块算钱。
六、为什么长文件费钱
很多人觉得:一份文件,它读一遍不就完了?
不是一遍。你在同一个对话里每问一句,前面所有的东西都要重新发给它一遍。 它自己不记事,软件只好每次把聊天记录连同文件从头念给它听(为什么会这样,《聊久了它就忘:上下文》细讲)。
拿一份 3 万字的合同算笔账。按 DeepSeek 给的 0.6 换算,3 万字大约 1.8 万词元。你把它发过去,然后接着问了 10 个问题:
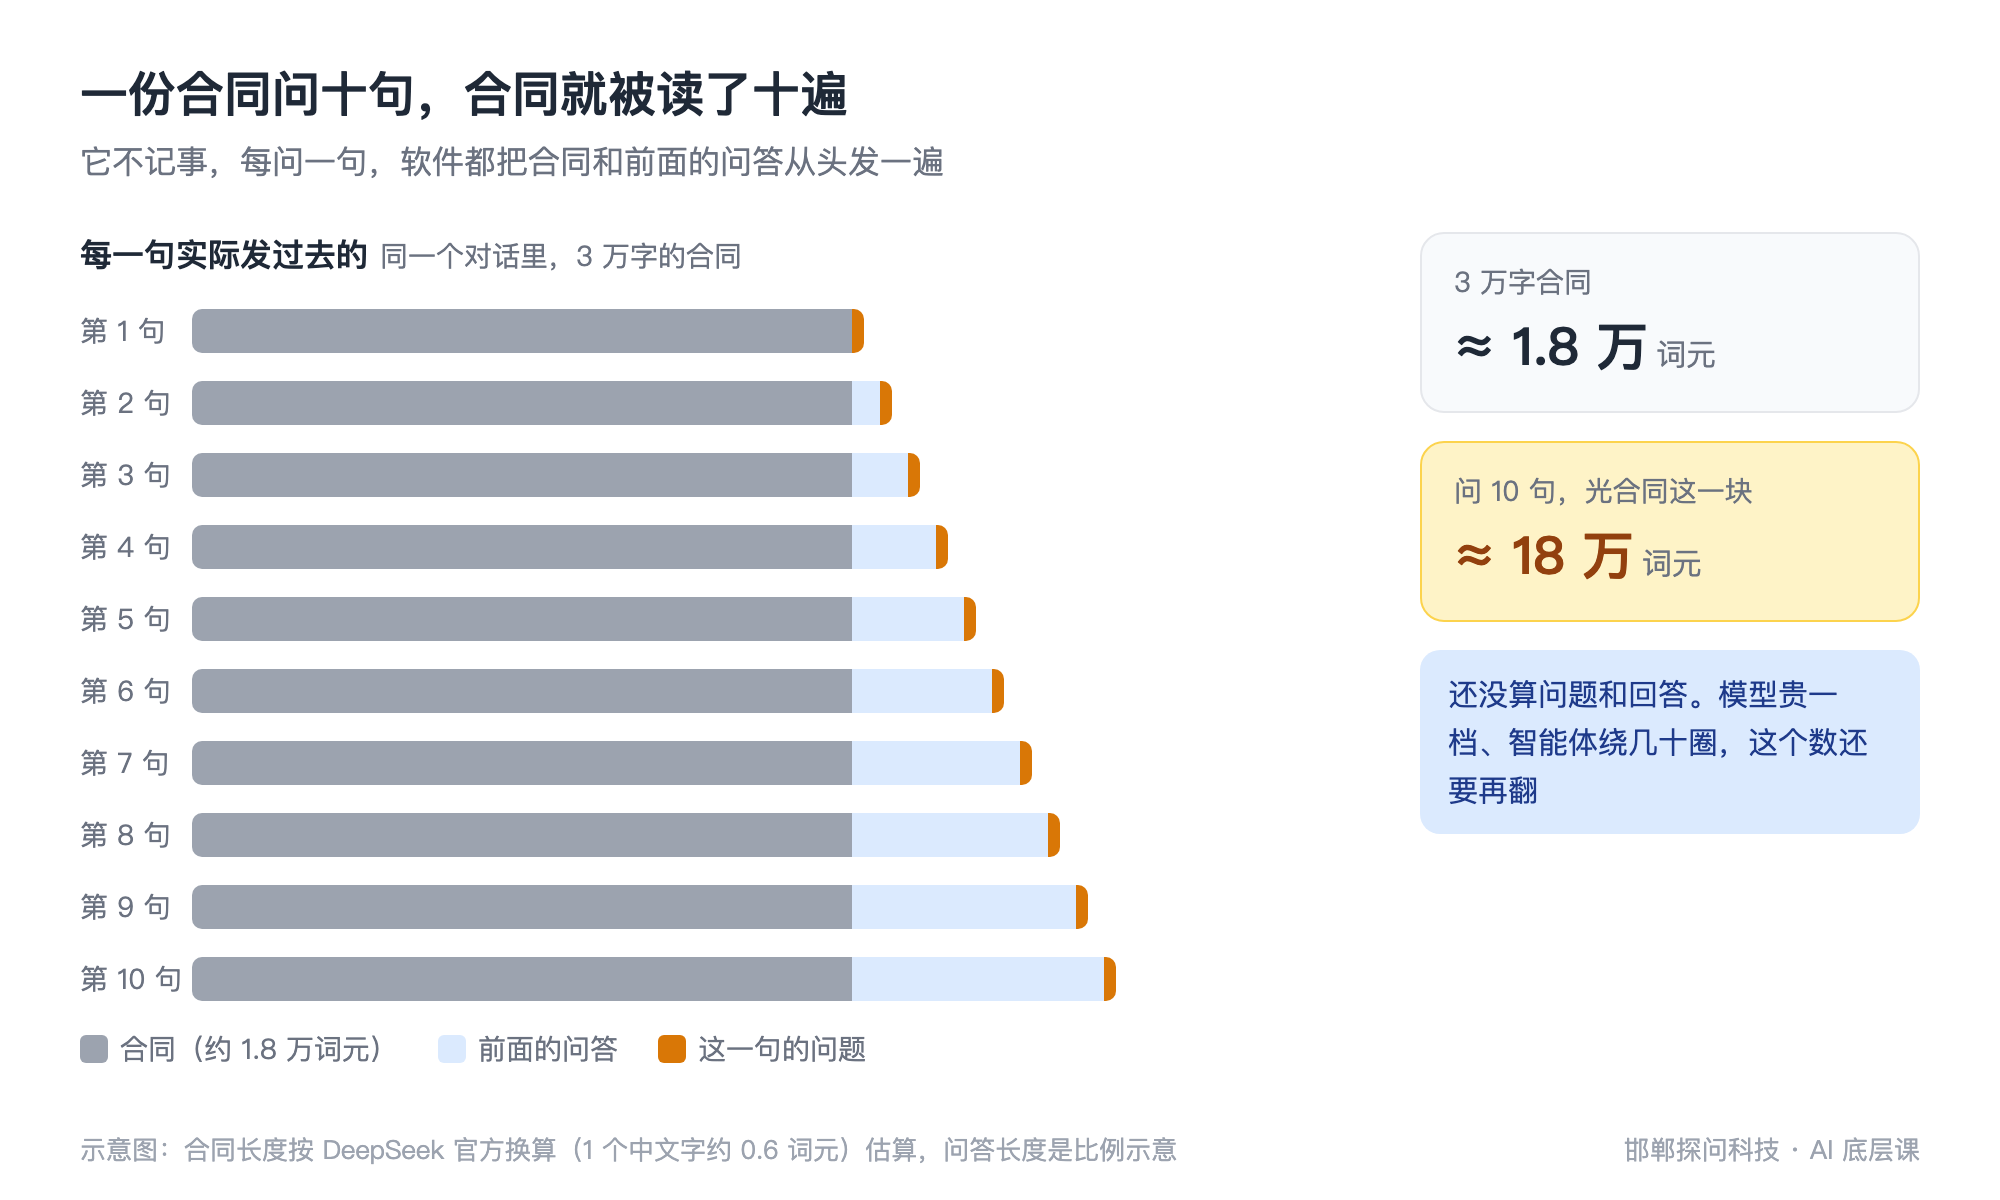
问 10 句,合同就被读了 10 遍,光合同这一块就是 18 万词元,还没算你的问题和它的回答。
这时候你可能会想:按上面的价,18 万词元也才几毛钱,费什么钱?
这话对,这一单确实不贵。但有三件事会把它放大:
- 模型贵一档,单价就翻几倍:同一个价格页上,DeepSeek 更强的 deepseek-v4-pro,高峰时段输入是每 100 万词元 9 元,是 flash 的 4 倍多。
- 智能体一件活要绕几十圈:每一圈都从头念,文件越长,越往后越贵(见《智能体是怎么替你干活的》)。
- 长度不光花钱,还占地方:它一次能看的长度有上限,也按词元算,塞得越多越容易看漏(《聊久了它就忘:上下文》细讲)。
所以,省钱和让它答得准,是同一个办法:
- 只给用得上的那部分:问付款条款,就只贴付款那几条,不贴整份合同。
- 一件事一个对话:换一份文件、换一件事,就开个新对话。
- 长资料先压一遍:先让它把长文件整理成一页要点,后面拿要点问。
一句话收住:长文件贵,不是贵在读一遍,是贵在每问一句都要从头再读一遍。
七、这对你用 AI 意味着什么
| 它的原理 | 所以你该 |
|---|---|
| 它按字块看,不按字看 | 卡字数给范围:说“80 到 120 字”,要准就让程序数或自己数 |
| 每家的词库不一样 | 比价格、比长度别只看数字:以软件显示的实际用量为准 |
| 输入、输出都收钱,输出更贵 | 别让它写废话:说清楚要多长、要什么格式,不要的就说不要 |
| 每问一句都从头念一遍 | 只贴用得上的那部分:问哪几条贴哪几条,别整份文件一丢 |
| 文件越长,越费钱也越容易漏 | 换件事就开新对话:长资料先整理成要点再问 |
速查卡
| 记住这几句 | 意思 | 细讲 |
|---|---|---|
| 词元(token) | 它读文字的最小单位,一块一块的字块,不是一个一个的字 | 本篇 |
| 中文一个字约 0.6 个词元 | DeepSeek 官方的大致换算,英文一个字母约 0.3 个;换个模型就不一样 | 本篇 |
| BPE | 切块的办法:谁常在一起就把谁粘成一块,粘出一本词库 | 本篇 |
| 词表 | 每家模型自己练出来的词库,同一句话各家块数不一样 | 本篇 |
| 输入、输出 | 发过去的和写回来的都按词元收钱,写回来的更贵 | 本篇 |
| 上下文窗口 | 它一次能看的长度上限,也按词元算 | 《聊久了它就忘:上下文》 |
| 为什么越聊越贵 | 每问一句,前面的聊天记录和文件都要从头念一遍 | 《智能体是怎么替你干活的》 |
动手练习(5 分钟)
练习:看看它卡不卡得准,再让程序来数
在豆包或 DeepSeek 里发:
帮我写一条朋友圈,宣传周末的会员活动,正好 100 字(标点不算)。把它写的复制到 WPS 或 Word 里,看左下角的字数统计,差了多少?
然后接着发:
你刚才写的是多少字?请一个字一个字数一遍再告诉我。多半跟 WPS 对不上,原因就是第四节讲的:它是按块看的。
装了 WorkBuddy(或 Codex)的,再发一句:
帮我写一条朋友圈,宣传周末的会员活动,80 到 120 字(标点不算)。
写完用程序数一下字数,不在范围内就改,改到符合为止。
再拿 WPS 数一遍。这一回能对上,因为数字的是程序,不是它。
常见问题
问:中文是不是比英文费词元? 答:看模型的词库。国内的大模型拿大量中文练过,常用中文词多半是现成的整块,中文并不吃亏:“人工智能正在改变我们的生活”和它的英文说法,DeepSeek 切中文是 4 块,切英文是 6 块。换成以英文为主练出来的词库,中文就可能多费一些。
问:发图片、PDF 也按词元算吗? 答:PDF 里的字,转成文字以后照样按词元算。图片也会先被换成它能处理的词元再读,所以也算量,具体怎么换见《它怎么看图、画图、做视频:多模态》。
问:DeepSeek 价格表上的“缓存命中”是什么意思? 答:你每次发过去的开头那一大段,经常跟上一次一模一样(前面的聊天记录、同一份文件)。DeepSeek 会把这部分记下来,一模一样的开头再发过来,就按“缓存命中”算:deepseek-flash 高峰时段命中缓存的输入每 100 万词元 0.04 元,没命中是 2 元。所以“从头念一遍”实际花的钱,往往没有原价算的那么多。但它照样占着能看的长度,看漏的问题不会因为便宜就消失。
下一篇
《它是怎么练出来的:预训练和微调》:它为什么总顺着你说,你的方案它总说好;怎么让它说真话。
参考资料
- DeepSeek API 文档,《Token 用量计算》(查阅于 2026 年 11 月 4 日):1 个中文字符约 0.6 个 token,1 个英文字符约 0.3 个 token;不同模型分词不同,实际用量以模型返回为准
- DeepSeek API 文档,《模型 & 价格》(查阅于 2026 年 11 月 4 日):按输入和输出的总 token 数计费;deepseek-flash 高峰时段输入(缓存未命中)2 元、输入(缓存命中)0.04 元、输出 8 元,deepseek-v4-pro 高峰时段输入(缓存未命中)9 元,均为每百万 tokens
- DeepSeek-AI,《DeepSeek-V3 Technical Report》,2024 年 12 月:分词器用字节级 BPE,词表约 128K
- Sennrich 等,《Neural Machine Translation of Rare Words with Subword Units》,2016 年:把 BPE 用来切词,常见的成块、少见的拆开
- 本篇切分实测(2026 年 11 月 4 日):DeepSeek-V3 在 Hugging Face 公开的 tokenizer.json、千问 Qwen3-8B 公开的 tokenizer.json、OpenAI 开源 tiktoken 库里 GPT-4o 用的 o200k_base 词表
学完测一测
4 道题,答对 3 道算过关
先别往回翻,凭读完的印象选。交卷后每道题都有讲解。
你让 AI 写"100 字的朋友圈",它总是多写或少写,来回改几次也卡不准。根本原因是什么?
同一个对话里,你发了一份长合同,接着问了 10 个问题,用掉的词元远远不止合同本身那么多。为什么?
你开了一家奶茶店,只想问加盟合同里的付款条款有没有坑。最该怎么做?
你在比较两家 AI 的价格,两家的输入单价一样,也都说一次能读 100 万词元。你该怎么判断?