假设你开了一家饭店,想让 AI 帮你回顾客的微信。有位顾客发来一句:
你们家包间最低消费多少?我花生过敏,哪些菜不能点?
你原样发给豆包。它多半会热情地回:“您好,包间最低消费一般在 500 到 1000 元之间,具体以门店为准;含花生的菜一般有宫保鸡丁、老醋花生……”
看着像样,可一个字都不能发出去。它说的是“饭店一般是这样”,不是“你家是这样”。
这篇就讲:怎么让它照着你家的情况答,以及两种常见做法各自会在哪儿翻车。整篇都用这家饭店、这一个问题。
一、它不认识你家:现在是闭卷考试
《大模型是怎么回答你的》讲过,大模型读过的东西都存在几千亿个“旋钮”里,练完就定型了。你家的菜单和包间规矩,它从来没读过。
没有,它也不会交白卷,而是接出一段“最像答案的话”,这就是它一本正经地胡说的来由。
打个比方:你现在让它做的是闭卷考试。考的是你家的事,课本它没见过,只能凭印象蒙。
办法也就出来了:改成开卷考试。 把你家的资料放在它手边,先翻再答。这一摞专门给它翻的资料,就叫知识库。说人话:知识库不是一种更聪明的 AI,就是你给它备好的那摞课本。
一句话收住:它不缺本事,缺的是你家的课本。
二、最省事的开卷:直接把资料贴给它
最简单的开卷,是把菜单和包间规矩直接贴进对话,再问那句话。这回它就能答对:包间最低消费 800 元(假设你家定的是这个数),含花生的是哪几道。
因为它每接一个字,都要回头看一遍前文,你贴的资料就在前文里。
两三页菜单这么干完全够用。麻烦出在资料一多:员工手册、进货单、活动方案、顾客评价,加起来几十万字。它能看见的前文有上限,塞太多中间的容易漏(见《聊久了它就忘:上下文》);每问一句都塞一遍,也太贵。这就像开卷考试,却让考生每答一题都把整本书从头读一遍。
所以资料一多,就得只翻相关的那几页。怎么挑,有两种做法。
一句话收住:资料少就整份贴,资料多了就得挑着翻。
三、做法一:切成小段,按意思挑几段
第一种做法,业内叫检索增强生成,英文缩写 RAG。拆开就是:先查(检索),把查到的塞进前文(增强),再接话(生成)。
它分两步走。
提前做好的一步:切段。 把所有资料切成几百字一段,再用一个专门的模型把每段换成一长串数字,业内叫向量。说人话:向量是一段话的“意思坐标”,意思相近,数字也相近。“花生过敏”和“含坚果,过敏者慎点”字面不一样,坐标却挨得很近。
每次提问的一步:挑段。 顾客那句话一进来,检索程序就在它和大模型之间演一出戏:
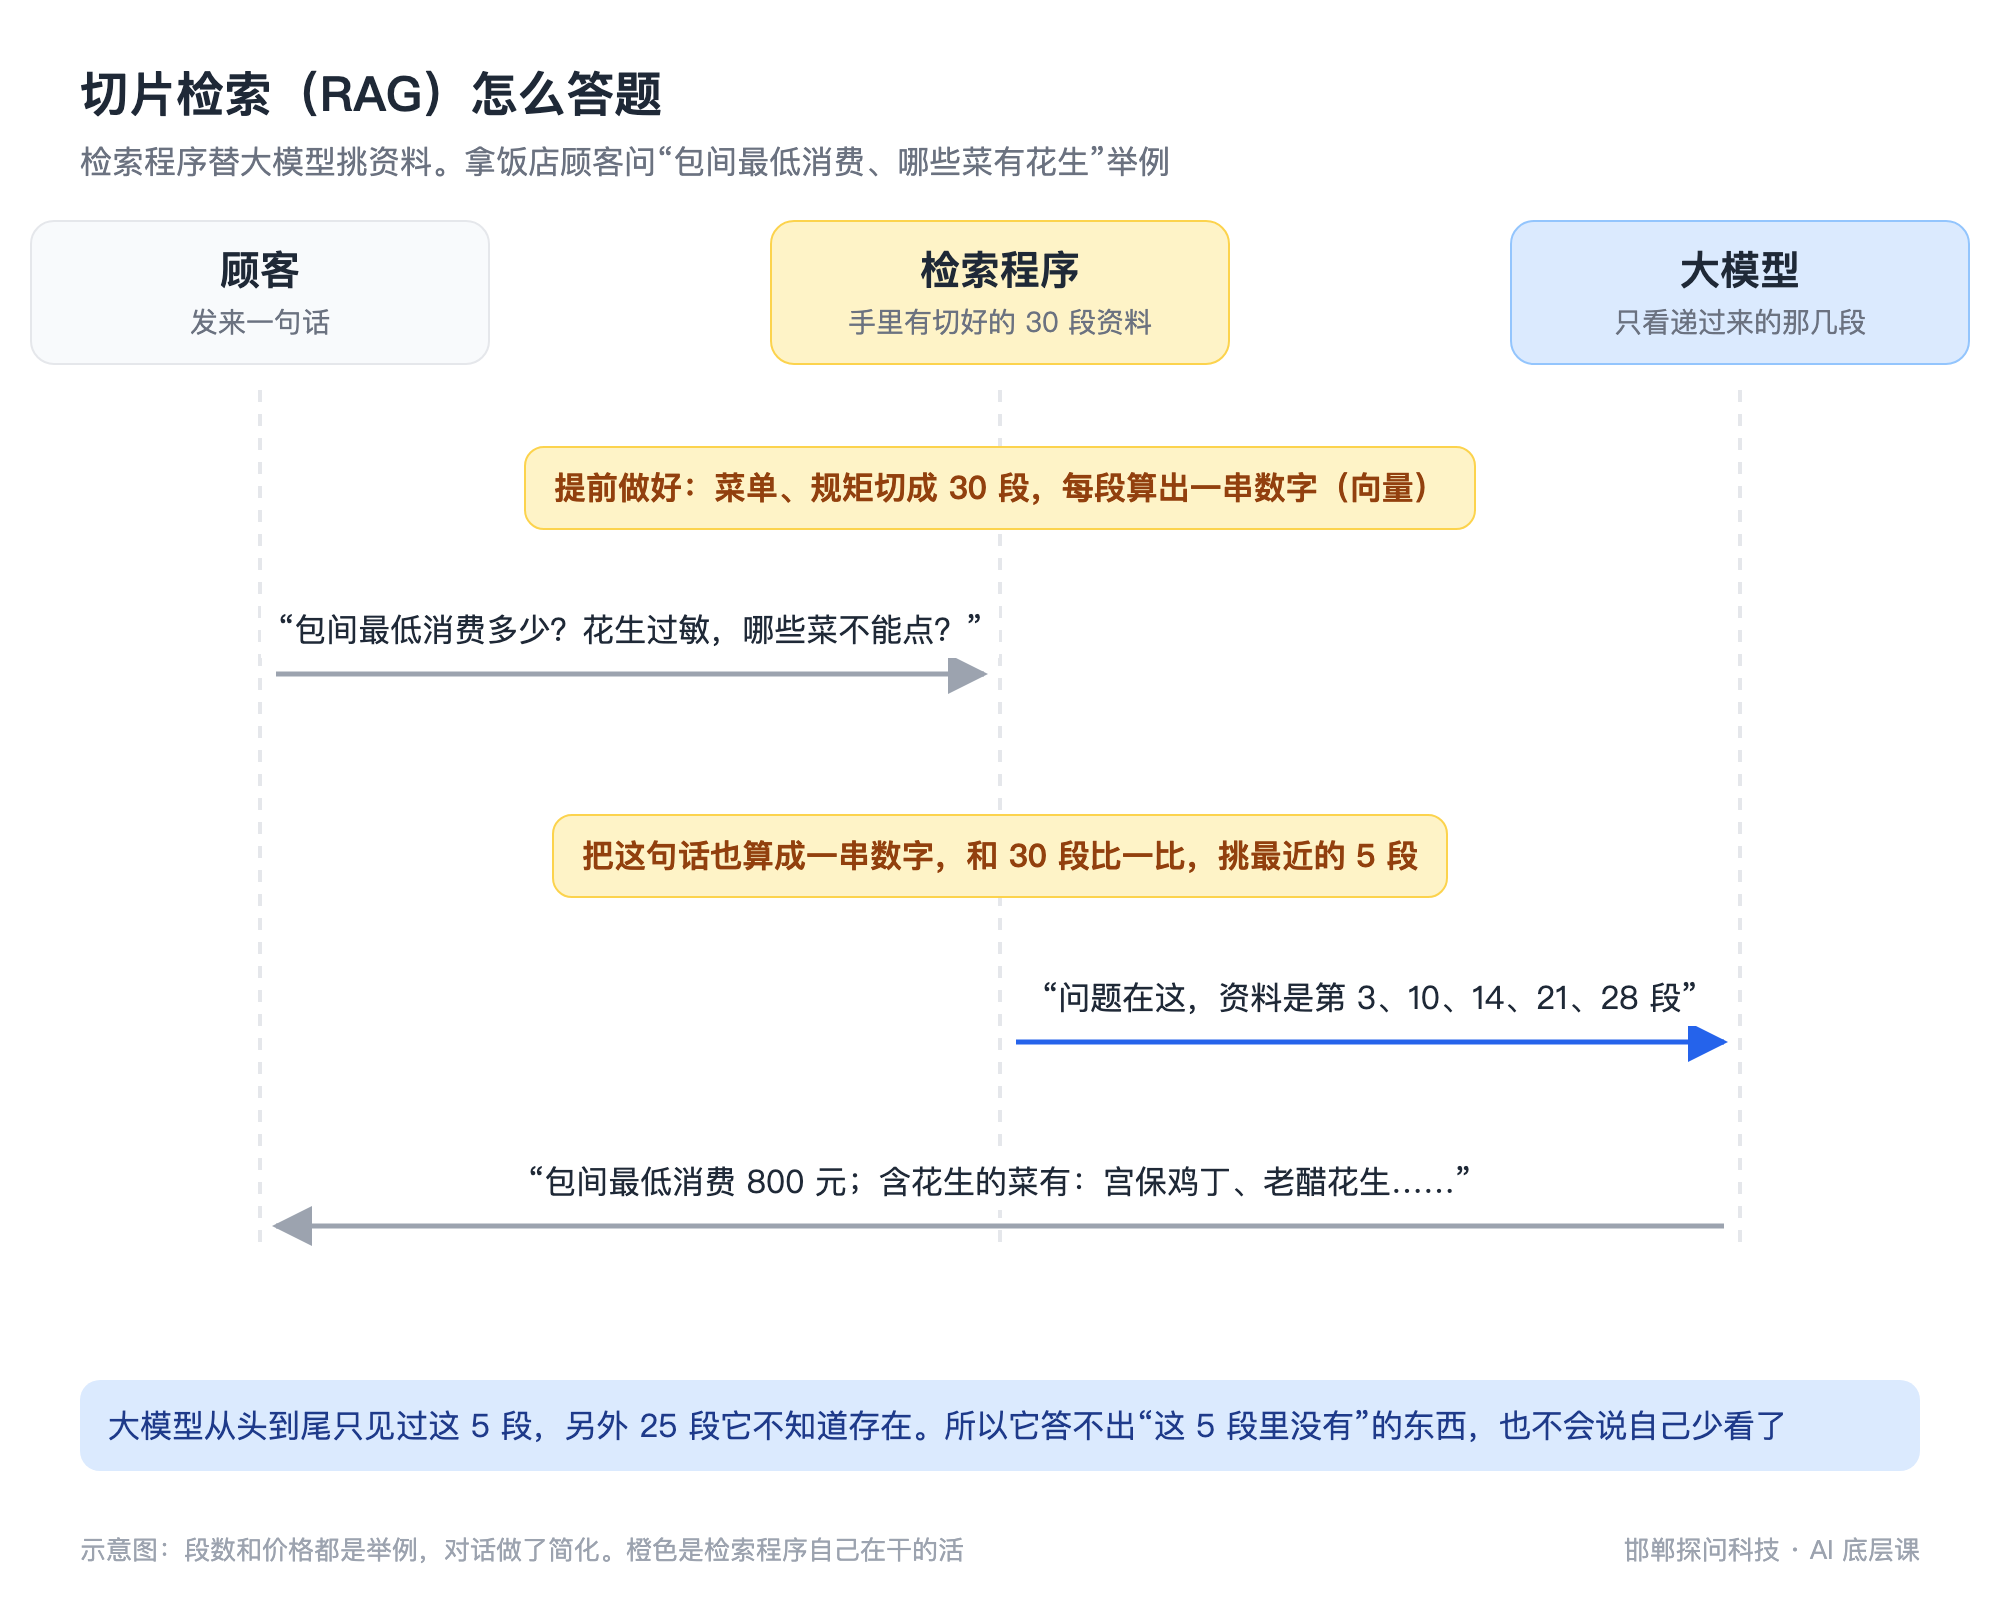
注意,大模型从头到尾没见过你的整份资料,只看到挑给它的那 5 段。好比开卷考试不许考生翻书,只许看助手按题目抄给他的 5 张小纸条。
一句话收住:切片检索=把资料切碎,按意思挑几段,塞给它看。
四、切片检索的短板:要看全文的题,会漏
5 张小纸条,答“包间最低消费多少”绰绰有余,规矩就写在一段里。
麻烦出在后半句:“哪些菜不能点?”
假设你家菜单 80 道菜,切成 30 段,其中 9 段有放花生的菜。检索程序只挑最像的 5 段,剩下 4 段不会交到大模型手里。大模型不知道自己少看了,照样笃定地列出“含花生的是以下几道”,少了好几道,语气跟全对时一模一样。
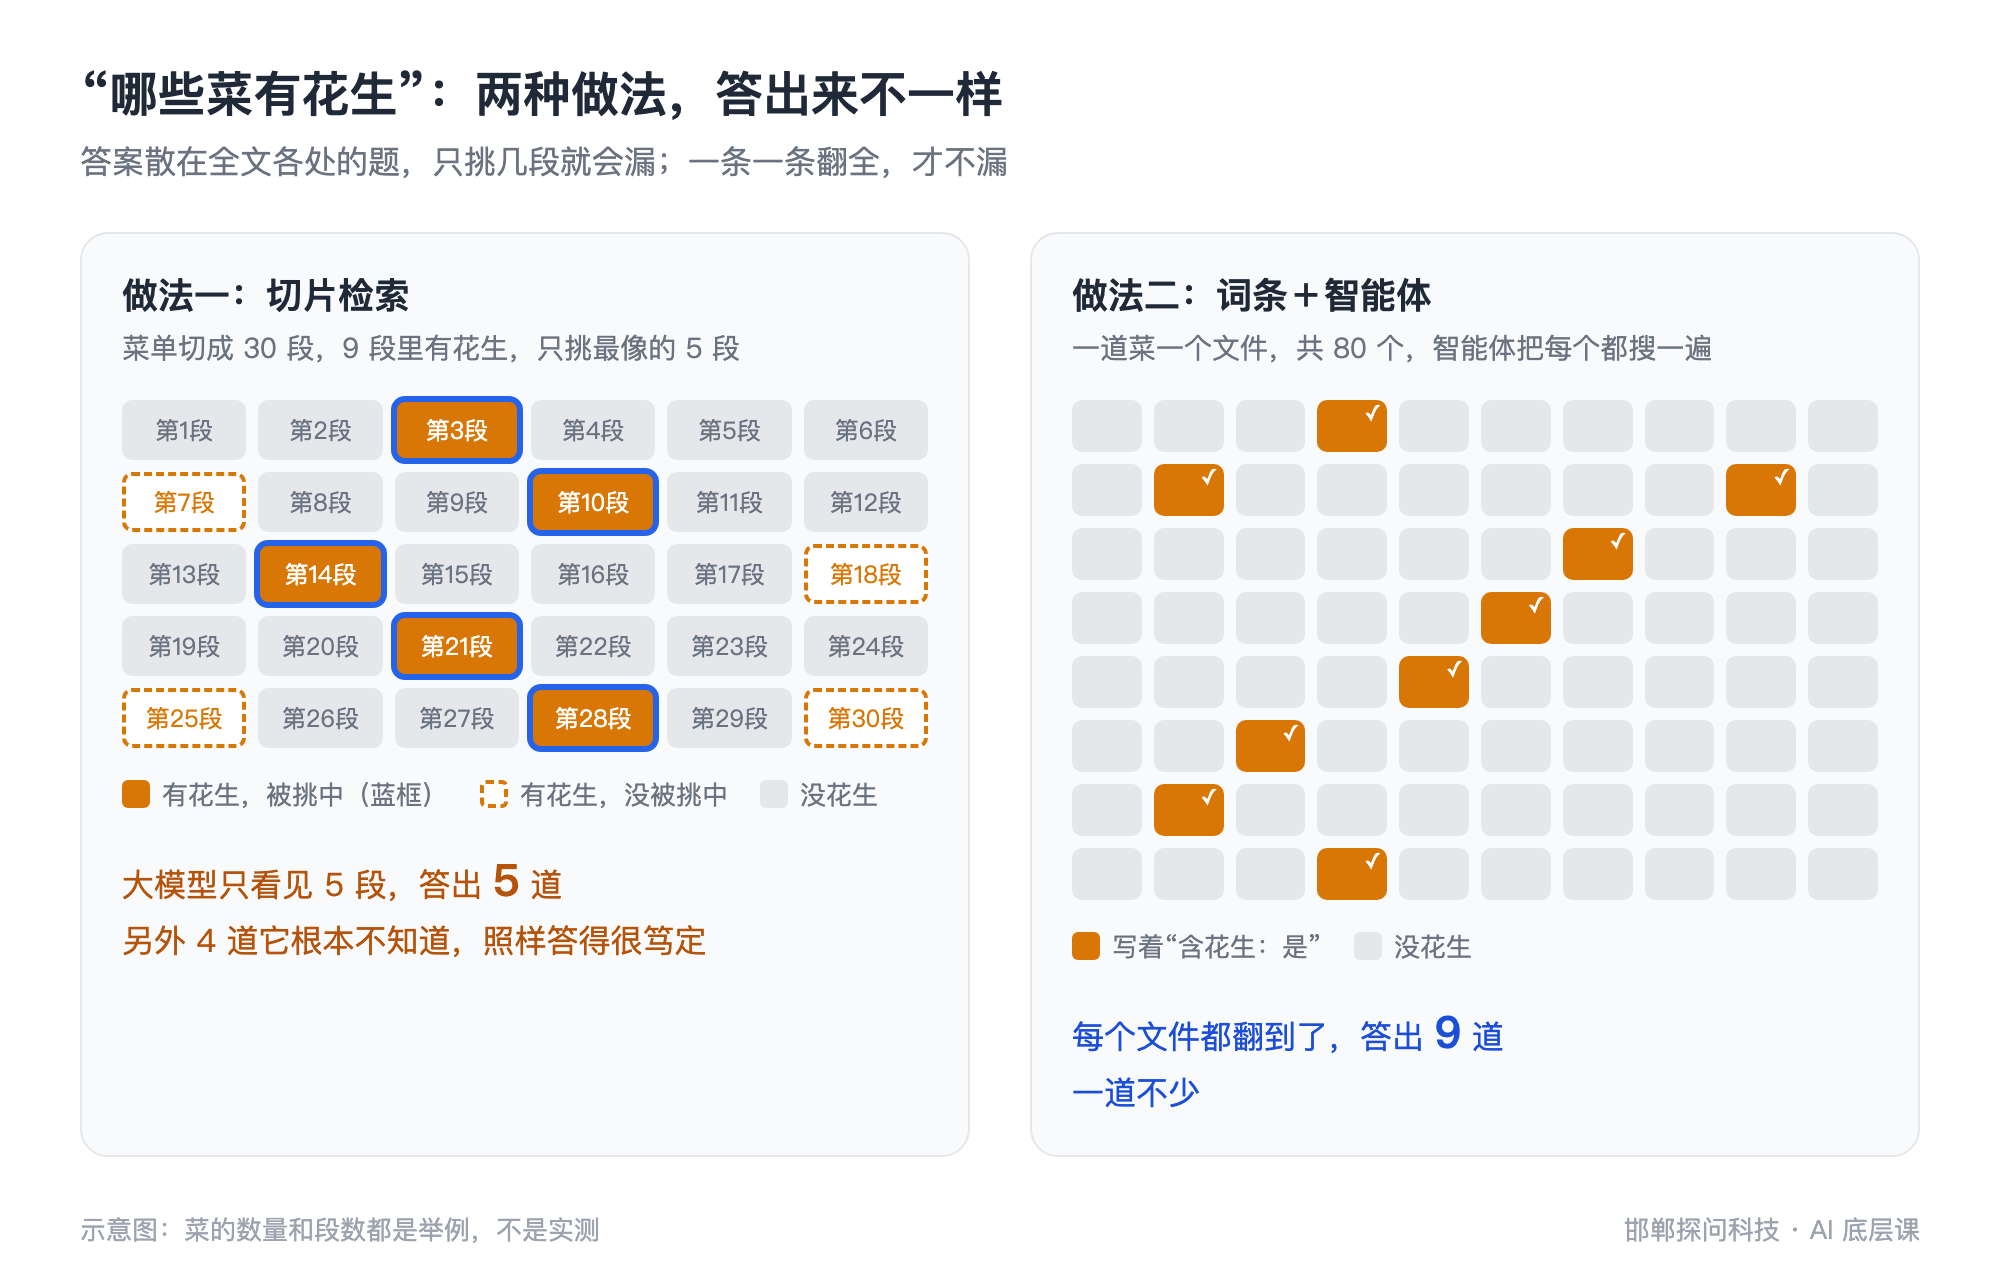
另外,切开以后前后会断(菜名在上一段,“加花生碎”在下一段),挑的也只是“意思像的”,旧菜单和新菜单长得像,它可能挑中旧的。产品会打补丁,但“只挑一部分”的根子不变。
一句话收住:切片检索擅长“找一句话”,不擅长“数一整本”。
五、做法二:整理成带目录的词条,让智能体自己翻
第二种做法不切了,把资料整理成一条一条的词条,放在一个文件夹里:
饭店知识库/
├── 目录.md          ← 每个词条一行:叫什么、一句话讲什么
├── 包间规矩.md
├── 菜品/
│   ├── 宫保鸡丁.md   ← 配料、价格、含花生:是
│   └── ……一道菜一个文件
└── 顾客常问.md
每个文件都是 Markdown 格式,说人话就是纯文字,人能直接读,AI 读得最顺。
关键在于,替它翻书的不再是只会挑段的检索程序,而是智能体,那个派到现场、能自己打开文件、自己搜的徒弟(下一篇细讲)。同一个问题,它这么干:
- 先打开
目录.md,看清都有什么; - 翻开
包间规矩.md,读到“最低消费 800 元”; - 把
菜品/下 80 个文件全搜一遍,找出所有“含花生:是”的,9 道,一道不少。
这回它真的从头翻到了尾,因为它能动手,一个一个翻。
2026 年 4 月,卡帕西(OpenAI 创始成员之一)把这个思路写成短文“LLM Wiki”,他说资料在一百来份、几百页这个量级,这样做效果出奇地好,向量检索都用不上。
顺手戳破一个误会:Obsidian 不是知识库。 它只是看、改 Markdown 文件的编辑器,就像 Word 不是你的合同;那一堆整理好的文件才是知识库。
你心里可能在想:一道菜一个文件,全整理一遍,我有这功夫,顾客的微信早回完了。
这话对,第一次确实费功夫。但整理这活本身就能交给 AI,你只核对价格和配料;而且整理一次,问一万次,回顾客、培训服务员、写朋友圈,翻的都是这套课本。
资料上万份时,切片检索更省事;大多数公司资料就几十上百份,整理成词条让智能体翻更稳。
一句话收住:词条+目录+智能体,等于让它自己翻书,想翻多少翻多少。
六、所以:你家资料整理得越清楚,AI 越懂你
AI 答得好不好,一大半取决于课本写得好不好。 课本里没有的,它翻不到;写得含糊,它答得含糊;新旧两个价都在,它就可能报错价。
所以别急着挑“知识库软件”,先整理这三份:
- 公司介绍:你是谁、在哪、做什么、营业时间、怎么联系。
- 产品价目:每样一条,写清名字、价格、包含和不包含什么、什么时候改的价。
- 客户常问:问得最多的二三十个问题,写成“问:……答:……”。
写的时候守住几条规矩:
- 一条只讲一件事。 一道菜一条,挑段、翻词条都不容易串。
- 数字写死,别写“一般”“左右”。 你写“800 元左右”,它就答“800 元左右”。
- 只留一个最新版。 别让“价目表_最终版”和“价目表_最最终版”同时躺着。
- 配一份目录。 每个文件一行,一句话说清它讲什么。
一句话收住:AI 懂你家多少,取决于你给它的课本写得多清楚。
这对你用 AI 意味着什么
| 它的原理 | 所以你该 |
|---|---|
| 旋钮里没有你家的事,不给资料它只能蒙 | 问你家的事,先给它资料:没给资料的回答一律不能直接发 |
| 资料少,整份贴进前文最准 | 资料就几页,直接贴:别为两页菜单去搭一套知识库 |
| 切片检索只挑几段给它看 | “有哪些”“一共几个”这类题别全信:要自己核数 |
| 智能体能把词条一条条翻全 | 要看全的活,交给智能体翻文件夹:资料整理成 Markdown 词条,配一份目录 |
| 课本写得含糊,它就答得含糊 | 先写好三份课本:公司介绍、产品价目、客户常问 |
速查卡
| 记住这几句 | 意思 | 细讲 |
|---|---|---|
| 闭卷和开卷 | 只凭旋钮答题叫闭卷;先翻你给的资料再答叫开卷 | 本篇 |
| 知识库 | 你给它备好的那摞课本,答题前先翻 | 本篇 |
| 检索增强生成(RAG) | 资料切成小段,按意思挑几段塞进前文,再接话 | 本篇 |
| 向量 | 一段话的“意思坐标”,意思近的数字也近 | 本篇 |
| 切片检索的短板 | 只挑几段,“一共几个”“有哪些”这类题会漏 | 本篇 |
| 词条+目录 | 一件事一个 Markdown 文件,配一份目录,让智能体自己翻 | 本篇 |
| Obsidian | 看、改 Markdown 的编辑器,不是知识库本身 | 本篇 |
| 智能体 | 现场拎着工具箱的徒弟,能自己打开文件、搜、翻 | 《智能体是怎么替你干活的》 |
| Markdown | 纯文字的写法,# 是标题,两个星号是加粗 |
《Markdown:AI 最顺手的文件格式》 |
动手练习(5 分钟)
同一个问题,闭卷考一次,开卷考一次
先在豆包或 DeepSeek 里,什么资料都不给,直接问(方括号里换成你自己的):
我家[店名]的[你卖得最多的一样产品]多少钱?包含哪些内容?看它是老实说不知道,还是编了一个像样的价。
然后新开一个对话,把这样产品真实的介绍和价格贴进去,再问一遍:
下面是我家的产品资料:
[把产品名、价格、包含什么、不包含什么贴在这里]

只根据上面的资料回答,资料里没有的就说"资料里没写",不要自己补。
问题:[你卖得最多的一样产品]多少钱?包含哪些内容?
两个回答摆在一起,哪个敢直接发给客户?
常见问题
问:我把资料传给 AI,它是不是就“学会”了,以后都记得? 答:不是。传资料不会拧动旋钮,它只是这一次答题时翻了你的资料。换个对话不给课本,它照样不知道。
问:豆包、元宝里“上传文件”“建知识库”的功能,用的是哪种做法? 答:各家没有全部公开。卡帕西点名说 NotebookLM、ChatGPT 的传文件问答和多数 RAG 系统走的是切片检索那一路;国内产品没公开,不好下定论。所以用这类功能问“一共几个”“有哪些”,要自己核一遍数。
下一篇
《知识库能解决哪些生意上的问题》:知道了知识库是怎么回事,你家第一件该拿它做什么。
参考资料
- Lewis 等,《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,NeurIPS 2020(提出检索增强生成:资料切段、建向量索引,每次提问挑最相关的 5 段或 10 段交给模型;文中把只靠参数答题称为“闭卷”,先检索再答称为“开卷”)
- 卡帕西(Andrej Karpathy),《LLM Wiki》,GitHub Gist,2026 年 4 月(由大模型整理、维护互相链接的 Markdown 词条,答题前先读目录;称在约 100 份资料、几百页的规模上效果出奇地好,可以不用向量检索;点名 NotebookLM、ChatGPT 传文件问答和多数 RAG 系统都是“提问时检索相关片段”的做法)
学完测一测
4 道题,答对 3 道算过关
先别往回翻,凭读完的印象选。交卷后每道题都有讲解。
你什么资料都不给,直接问 AI"我家包间最低消费多少",它回了一个像模像样的数。为什么这个数不能信?
用切片检索问"哪些菜含花生",AI 列出的菜少了好几道,语气却很笃定。漏掉的根子在哪?
你家只有两三页菜单,想让 AI 回顾客"有没有不辣的菜"。最该怎么做?
你在整理饭店的价目资料,准备交给 AI 用。下面哪种写法最不容易让它报错价?